Ein Beitrag von Tobias Hetz (Stand: 11. November 2026)
Schlagzeilen über die neuesten Tools und leistungsstärksten LLMs prägen derzeit den fachlichen Diskurs in der rasant wachsenden Legal Tech Branche. Doch ein entscheidender Faktor, um das Potenzial dieser Innovationen effektiv ausschöpfen zu können, wird oft nur stiefmütterlich behandelt: die Qualität der zugrundeliegenden Dateninfrastruktur.
Ohne verlässliche, leicht auffindbare und gut strukturierte Daten entfalten selbst die besten Tools am Markt nur begrenzten Mehrwert und die erhofften Kosten- und Skaleneffekte bleiben aus. Was schon für Menschen die Arbeit mühsam gemacht hat, wird beim Einsatz von Technologie schnell zum strukturellen Problem.
Die gute Nachricht: Insbesondere im öffentlichen Sektor ist die Ausgangslage oft besser, als man zunächst denkt. Dies liegt nicht zuletzt an den vielfältigen Rechenschafts- und Dokumentationspflichten, die greifen. Ob DSGVO, Informationsfreiheitsgesetz (IFG), Haushalts- oder Vergaberecht, all dies setzt saubere Dokumentation voraus, die externen Prüfmechanismen standhalten muss. Auch wenn saubere Dokumentation nicht zwangsläufig mit struktureller Qualität der Daten einhergeht, bildet sie doch ein gutes Fundament, um eine saubere Struktur aufzubauen.
1. Bedarfsanalyse
Für Rechtsabteilungen öffentlicher Unternehmen dürfte der in diesem Artikel vertretende logische Ausgangspunkt, um sich dem Thema zu nähern, für wenig Überraschung sorgen. Genau wie bei einer öffentlichen Vergabe steht zu Beginn eine Bedarfsanalyse. Erst danach gilt es, die angestrebte Leistung zu beschreiben und passende Kriterien zu entwickeln.
Wer nicht weiß, welches Problem mit der Implementierung gelöst werden soll, wird nicht zu einer passenden Lösung finden. „Data Readiness“ lässt sich nur im Verhältnis zu konkreten Anwendungsfällen bewerten. Diese gilt es zu definieren.
Für jeden Anwendungsfall sollten mindestens die folgenden Fragen beantwortet werden:
- Welche Daten werden benötigt?
- In welcher Form müssen sie für den Anwendungsfall vorliegen?
- Welche rechtlichen und organisatorischen Anforderungen gelten für die angestrebte Nutzung?
- Welche Nutzergruppen oder Systeme brauchen Zugriff, und welche Zugriffsbeschränkungen müssen bestehen bleiben?
2. Dateninventur
Ist der Bedarf ermittelt, wird es Zeit für eine ehrliche Bestandsaufnahme. Dabei handelt es sich um nichts anderes als eine gute alte Inventur. Wer bereits im Einzelhandel gearbeitet hat oder, wie der Autor, Erfahrungen in der Wirtschaftsprüfung sammeln durfte, weiß: Das ist nicht gerade die spannendste aller Aufgaben. Vermutlich bleibt sie auch deshalb oft auf der To-do-Liste stehen. Dabei ist ein ehrlicher Blick auf den Status quo unverzichtbar, um strukturelle Änderungen zu erreichen.
Wichtig: Die Inventur sollte sich eng an den im Rahmen der Bedarfsanalyse entwickelten Anwendungsfällen orientieren. Ohne diese Eingrenzung wird die bezweckte Bestandsaufnahme zu unscharf und die Transformation scheitert.
Für jeden identifizierten Anwendungsfall gilt es, passende Datenquellen aus dem Bestand zu identifizieren und deren Speicherorte zu ermitteln.
Für jede Datenquelle sollte für die Übersicht mindestens folgende Daten festgehalten werden:
- Dokumenttypen und ungefähre Mengen
- Zeitspanne (ältester und jüngster Bestand)
- Format
- Benennungs- und Ablagelogik
- Verantwortlichkeiten und Zugriffsberechtigungen
Zudem sollte zeitgleich eine Bestandsaufnahme etwaiger Silos stattfinden. Kritisch zu hinterfragen ist, ob die verantwortlichen Personen Zugriff auf alle Inhalte haben, die sie für ihre Aufgabe benötigen. Das betrifft nicht nur technische Berechtigungen. Verstreute Postfächer, persönliche Laufwerke, externe Projektplattformen oder das Wissen einzelner Personen können dazu führen, dass relevante Unterlagen zwar existieren, im Bedarfsfall jedoch nicht verfügbar und auch für ein neues Tool nicht verwendbar sind.
Die Bewertung bestehender Defizite erfolgt im Wesentlichen anhand von fünf Kriterien: Vollständigkeit, Konsistenz, Aktualität, Richtigkeit, Zugänglichkeit, Compliance. Eine Aufzählung typischer Befunde überlasse ich dabei Ihrer Phantasie (oder Erfahrung).
Tipp: Bereits bei der Inventur sollte der Schutzbedarf mitgedacht werden. Enthält der Bestand personenbezogene Daten? Welche Vertraulichkeits- oder Geheimhaltungspflichten gelten? Welche Aufbewahrungs- und Löschfristen bestehen? Dies ist auch eine gute Gelegenheit, mal wieder das Verzeichnis von Verarbeitungstätigkeiten nach Art. 30 DSGVO zu aktualisieren.
Eine einfache Matrix zur Bewertung des Bestands könnte etwa so aussehen:
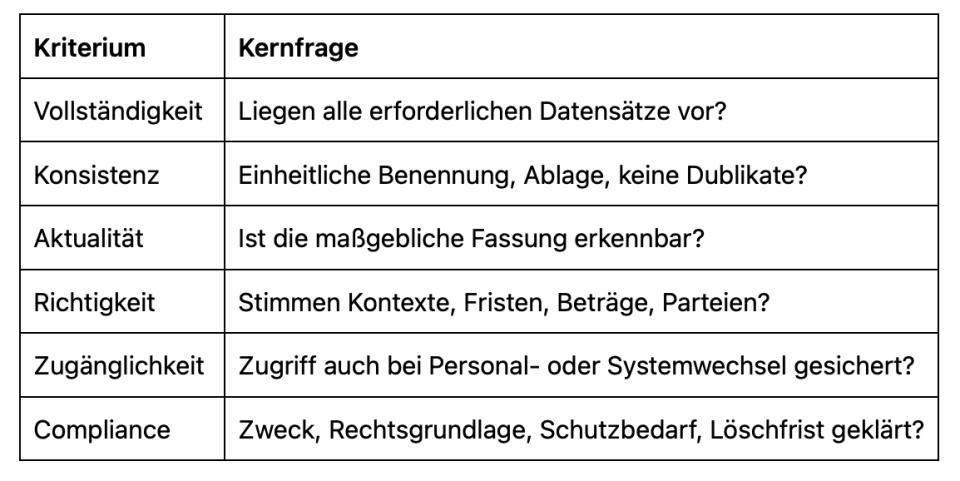
Die Ergebnisse sollten in folgender Aufteilung dokumentiert werden. Die jeweiligen Dokumente dienen dabei zugleich als Leitfaden, auf den im Rahmen der Transformation immer wieder zurückgegriffen und an dem das Vorgehen ausgerichtet werden kann:
- Datenkatalog bzw. Bestandsverzeichnis: alle erfassten Quellen und Bestände mit Format, Umfang, Zeitraum, Verantwortlichen und Schutzbedarf
- Lücken- und Befundliste: fehlende oder unvollständige Bestände, Qualitätsmängel, uneinheitliche Ablagen
- Verantwortungsübersicht: wer ist fachlich und technisch zuständig, wer darf darauf zugreifen
- Priorisierte Liste der Anwendungsfälle: welche Bestände werden zuerst bereinigt, digitalisiert oder mit Metadaten versehen
- Maßnahmenplan: Auflistung der durchzuführenden Anpassungen, um das identifizierte Ziel zu erreichen
3. Datenaufbereitung
Nun zur Kernfrage: Wie sollte die Datenaufbereitung im Idealfall aussehen? Diese Frage lässt sich mit dem unter Juristen beliebten „Es kommt darauf an“ beantworten. Die Aufbereitung hängt stark vom gewählten Anwendungsfall ab und richtet sich nach dem jeweils ermittelten Bedarf. Welche Anforderungen für den konkreten Anwendungsfall gelten, kann letztendlich nur durch den Endanwender festgelegt werden. Um jedoch praxistaugliche Lösungsansätze aufzuzeigen, werden im Folgenden Best-Practice-Tipps in einem möglichen Anwendungskontext beleuchtet. Die Auflistung ist nicht abschließend.
Anmerkung:Die vorgestellten Tipps basieren auf der Annahme, dass die Daten bereits in digitaler Form vorliegen. Die grundsätzliche Digitalisierung von Daten soll nicht Gegenstand dieses Artikels sein.
a) Einsatz einer einheitlichen Taxonomie
Eine einheitliche Taxonomie schafft ein gemeinsames Vokabular für Dokumente und Vorgänge. Wenn dieselbe Vertragsart als „Mietvertrag“, „Raummiete“ oder als „Gewerbemiete“ eingestuft wird, beeinträchtigt dies die Auffindbarkeit der Dokumente. Kanzleien legen daher häufig sogenannte „House-Styles“ fest und verhindern damit, dass jeder Mitarbeiter sich seinen eigenen Stil einbringt.
Eine einheitliche und zentral gesteuerte Kategorisierung verbessert und ermöglicht die kategorieübergreifende Suche und Auswertung. Obwohl Volltext- und semantische Suchen auch unterschiedliche Begriffe auffinden, ersetzt dies keine einheitlich gepflegten Kategorien für zuverlässige Filter.
Legen Sie zu verwendende Statusbezeichnungen (z.B. „approved“) für Dokumente zentral fest. Außerdem ist es ratsam, eine zentrale Legende anzulegen, wann welcher Status gesetzt werden darf. In Vertragsmanagementsystemen können solche Prozesse vollständig technisch gesteuert und an bestimmte, per Software festgelegte Voraussetzungen geknüpft werden.
Angelegte Kategorien und Statusbezeichnungen sollten dabei restriktiv und präzise vergeben werden. Sind sie zu grob, gehen rechtlich relevante Unterschiede verloren. Sind sie zu kleinteilig, leidet die Vergleichbarkeit. Die Freigabe neuer und die Zusammenführung alter Kategorien sowie die Taxonomie sollten nur über eine klar definierte zuständige Stelle erfolgen.
Tipp: Bei den Begrifflichkeiten empfiehlt es sich, die Bezeichnung so weit wie möglich am Wortlaut der einschlägigen Gesetze oder Industriestandards zu orientieren, um auch in der Außenkommunikation Missverständnisse zu vermeiden.
b) Gezielter Einsatz strukturierter Daten
Moderne Tools verarbeiten auch unstrukturierte Inhalte. Nicht jede Anwendung setzt voraus, dass zuvor alle Daten tabellarisch erfasst wurden. Für zuverlässige und einheitlich arbeitende Filter bleiben strukturierte Felder dennoch unverzichtbar. Ziel ist nicht, jedes Dokument vollständig in eine Tabelle zu übertragen, sondern den Text nutzbar zu machen und dort mit strukturierten Informationen zu ergänzen, wo der Anwendungsfall sie benötigt.
Strukturierte Daten sind Informationen, die nach einem festen, vordefinierten Schema angeordnet sind. Sie lassen sich leicht in Zeilen und Spalten, wie in einer klassischen Tabelle oder einer Datenbank, ablegen, speichern und maschinell auswerten.
Gerade juristische Arbeit erzeugt jedoch auch überwiegend unstrukturierte Daten: Verträge und Gutachten als Fließtext, E-Mails, Vermerke, gescannte Akten. Die relevanten Informationen befinden sich darin nicht immer an derselben Stelle. Eine Haftungsgrenze ergibt sich mitunter erst aus dem Zusammenspiel mehrerer Klauseln und eines Nachtrags.
Ein paar bewährte Regeln für die Praxis:
Ein Feld, eine Information: Beginn und Ende eines Vertrages gehören in getrennte Felder, nicht in ein gemeinsames Feld „Laufzeit: 01.01.2025 bis 12.05.2027“. Insbesondere Vertragsvorlagen können über ausgeblendete Tabellen oder gleich in Formularform gestaltet werden.
Einheitliche Formate: Etwa Datumsangaben im Format JJJJ-MM-TT (ISO 8601), Beträge als Zahl mit separater Währungsangabe, Fristen als Zahl mit Einheit, etwa „3“ und „Monate“.
Auswahl statt Freitext: Daten, die ausgewertet werden sollen, gehören in eine Auswahlliste, nicht in das Feld „Bemerkungen“. Der Einsatz von Dropdown-Menüs, die über zentrale Backbone-Dokumente gesteuert werden, spart zudem bei der Erstellung Zeit und sorgt für einheitliche Begrifflichkeiten.
Gegliederte Dokumente: Durchgängige Überschriften, nummerierte Klauseln, Anlagen als eigene Dateien erleichtern es modernen Tools, Textabschnitte zuzuordnen und als Quelle nachvollziehbar anzugeben. Bei Dokumenten sollten Sie die Zuordnung über die Metadaten hinterlegen (mehr dazu im nächsten Abschnitt).
c) Einsatz von Metadaten für eine langfristige Datenstruktur
Metadaten beschreiben ein Dokument, ohne dessen vollständigen Inhalt zu ersetzen. Bei einem Vertrag sind dies beispielsweise: Vertragsart, Vertragspartner, Beginn, Status, zuständige Person, Vertraulichkeitsstufe sowie Verknüpfungen zu einem Projekt, einem Vergabeverfahren oder einem Nachtrag. So lässt sich gezielt suchen und der Zusammenhang zwischen den Dokumenten durch Tools abbilden.
Alle Dokumente, z. B. eines Vergabeverfahrens, lassen sich auf diese Weise bündeln, ohne dass sie zwangsläufig in einem Ordner abgelegt werden müssen. Auch bereichsübergreifende Dokumente, die mit dem Verfahren verknüpft sind, aber kein direkter Anhang der Vermerke sind, bleiben so jederzeit auffindbar. Ebenso wird dem versehentlichen Verschieben vorgebeugt bzw. das daraus entstehende Risiko minimiert. Ein festes Benennungsmuster ergänzt dies und hilft, die Dokumentation einheitlicher zu gestalten.
Ein praxistaugliches Metadatenschema bleibt schlank: wenige Felder, die tatsächlich benötigt und konsequent gepflegt werden. Die Erfassung sollte bereits im Rahmen der Erstablage erfolgen, nicht erst, wenn die Dokumentation gegebenenfalls Monate später bereinigt wird. Die schlanke Gestaltung hält den damit verbundenen Arbeitsaufwand gering.
Zudem muss feststehen, wer die Angaben prüft und pflegt. Beispielsweise schützt eine Vertraulichkeitskennzeichnung allein kein Dokument. Sie erfordert wirksame Berechtigungsregeln und technische Kontrollen. Hinterlegen Sie zudem Aufbewahrungs- und Löschfristen als Metadaten, damit Tools diese berücksichtigen können.
Im Idealfall sollten Metadaten auch für die Versionierung eingesetzt werden. Statusangaben wie „final“ oder „final_neu“ gehören für eine effektive Strukturierung nicht in den Dateinamen.
Tipp: Metadaten sollten im externen Datenverkehr gegebenenfalls entfernt werden, da sie unbeabsichtigt interne Informationen preisgeben können. Dabei ist jedoch zu berücksichtigen, dass diese auch einen Nutzen mit sich bringen können. Wichtig ist, dass die Entscheidung darüber bewusst getroffen und die Abwägung in die internen Prozesse integriert wird.
d) Standardisierte Dokumente
Standardisierte Dokumente schaffen im Unternehmensalltag wiedererkennbare Muster, die von Software zuverlässig erkannt und ausgewertet werden können. Ein fester Aufbau, eine einheitliche Reihenfolge der Klauseln und definierte Eingabefelder machen Dokumente dabei für Mensch und System gleichermaßen leichter lesbar und ermöglichen deren Analyse.
Folgende Stellschrauben können die Standardisierung von Dokumenten verbessern:
- “Single Point of Truth”: Kerndaten aus einem zentral gepflegten Stammdatensatz beziehen
- Erstellung von Vorlagen mit vordefinierter Zuordnung zu Anwendungsfällen und einem einheitlichen Aufbau
- Strukturierte Eingabe statt Freitext: Kerndaten (Vertragspartner, Vertragsart, Laufzeit, Beträge, Organisationseinheit, Vertraulichkeit) über Eingabemasken erfassen, nicht per E-Mail oder Fließtext
4. Ausblick
Sobald die Qualität der zugrunde liegenden Dateninfrastruktur die für den Bedarf definierten Kriterien erfüllt, folgt die Auswahl der passenden Tools. Bereits in der Planungsphase sollten Governance-Strukturen mitgedacht werden. Je stärker Agentic AI für den spezifischen Use Case zum Einsatz kommen soll, desto engmaschiger müssen diese Strukturen ausgestaltet sein. Sowohl während der Implementierung als auch im operativen Betrieb empfiehlt sich unter anderem der Einsatz eines AI-Observability-Systems sowie Benchmarking-Tests, um die Leistungsfähigkeit und Zuverlässigkeit kontinuierlich zu überprüfen.
*KI-Hinweis: Im Rahmen der Erstellung und des Reviews dieses Beitrags wurden die KI-Modelle Claude Sonnet 5 und GPT-5.5 eingesetzt.